Перейти к содержимому
Статья

RAID не сохраняет файлы: что на самом деле произойдет с данными при отказе диска в NAS

Домашний NAS с четырьмя жесткими дисками часто настраивают по простой схеме: RAID 5 или его фирменный аналог, один диск можно потерять, значит фотографии, документы и рабочий архив защищены. В действительности RAID решает гораздо более узкую задачу.

BadMadSam
RAID не сохраняет файлы: что на самом деле произойдет с данными при отказе диска в NAS

Автор: Изображение создано с помощью ChatGPT

Он позволяет массиву продолжить работу после отказа определенного числа накопителей, но не создает независимую копию файлов, не возвращает удаленную папку, не отменяет действия шифровальщика и сам проходит через опасный период при восстановлении после отказа. У современных HDD большой емкости этот период может означать чтение десятков терабайт с оставшихся дисков. Отдельная проблема находится уровнем выше RAID: если файловая система не хранит контрольные суммы пользовательских данных, массив может знать, что все диски формально исправны, но не иметь надежного способа определить, какая из нескольких прочитанных версий блока правильная. Поэтому выбор RAID 1, RAID 5, RAID 6, SHR или RAIDZ имеет смысл только вместе с пониманием трех разных механизмов: отказоустойчивости, контроля целостности и резервного копирования.

RAID защищает от отказа диска, а не от потери данных

В двухдисковом зеркале один блок данных хранится на двух накопителях. Если один HDD перестает отвечать, система читает вторую копию и продолжает обслуживать файлы. В RAID 5 данные и информация четности распределяются между дисками так, чтобы содержимое массива можно было восстановить при отказе одного накопителя. RAID 6 хранит дополнительную информацию четности и способен пережить отказ двух дисков. У Microsoft Storage Spaces логика описывается аналогично: two-way mirror выдерживает отказ одного диска, three-way mirror двух, single parity одного, dual parity двух. Цена отказоустойчивости различается. Зеркало расходует больше емкости, а parity-массивы эффективнее используют дисковое пространство, но требуют вычисления и записи четности и обычно хуже переносят случайную запись. Microsoft подробно разделяет mirror и parity именно по отказоустойчивости, емкости и характеру нагрузки.

Отсюда следует ограничение, которое название RAID скрывает от владельца NAS. Отказоустойчивость существует только для предусмотренного типа отказа. Если в RAID 5 умер один диск, массив становится degraded, но файлы еще доступны. Если до завершения rebuild перестанет читаться второй накопитель настолько, что необходимые данные нельзя будет реконструировать, допустимое число отказов превышено. RAID 6 оставляет в такой ситуации еще один уровень избыточности. Зеркало из двух дисков после отказа одного тоже превращается в систему с единственной оставшейся копией. Сам факт, что вчера NAS показывал зеленый статус RAID, ничего не гарантирует после первого отказа: с этого момента конфигурация уже другая.
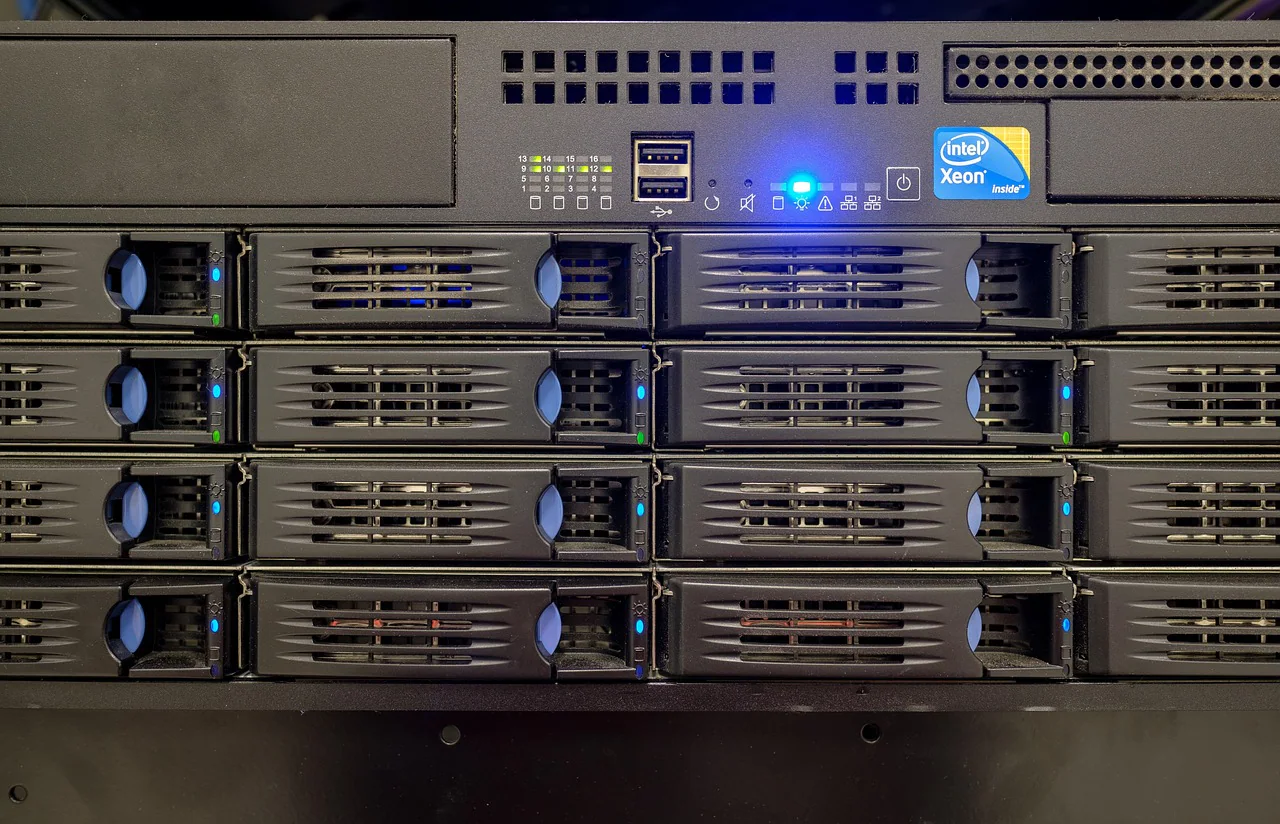
ряд жестких дисков установлен в серверные корзины с горячей заменой

Фото: Bru-nO

RAID также не видит смысл файловых операций. Если пользователь удалил каталог Фото/2024, файловая система корректно сообщает массиву о новых записях метаданных. RAID добросовестно записывает это изменение на диски. Если приложение перезаписало проект поврежденной версией, массив сохранит поврежденную версию. Если учетная запись с правом записи была захвачена шифровальщиком и тот изменил доступные файлы, RAID размножит или защитит четностью уже зашифрованные данные. В этих случаях ни один HDD физически не обязан ломаться, поэтому механизм отказоустойчивости вообще не получает события, от которого должен защищать.

Резервная копия работает иначе именно потому, что существует отдельно от рабочего набора данных. Seagate в документации своих NAS прямо рекомендует дополнительно копировать данные на DAS или другой NAS для защиты от отказа диска и других точек отказа, включая оборудование и сеть. Это хороший критерий, позволяющий быстро отделить RAID от backup: если изменение рабочего файла немедленно становится частью того же хранилища, независимой резервной копии этого состояния не появилось. RAID может обеспечить доступность сервиса, пока меняют диск. Backup должен позволить получить данные после события, которое RAID уже корректно записал или пережить не смог.

Самый тяжелый момент для массива начинается после того, как неисправный диск уже заменили

После установки нового HDD массиву необходимо восстановить отсутствующие данные. В зеркале они копируются с сохранившейся стороны. В RAID 5 система читает оставшиеся данные и четность и вычисляет содержимое нового накопителя. В RAID 6 реконструкция использует более сложную схему с двумя независимыми наборами информации четности. Процесс называется rebuild, и именно во время него исправные до этого диски получают длительную последовательную нагрузку чтения.

Для оценки масштаба достаточно посчитать объем. Массив из четырех HDD по 20 ТБ содержит физически 80 ТБ дискового пространства. После отказа одного накопителя RAID 5 должен восстановить данные нового 20-терабайтного диска, читая необходимые блоки с трех оставшихся. Даже если предположить устойчивые 200 МБ/с на всем протяжении операции и полностью исключить пользовательскую нагрузку, последовательное чтение 20 ТБ занимает около 27,8 часа. Реальный rebuild может идти заметно дольше: скорость HDD различается между внешними и внутренними дорожками, NAS одновременно обслуживает клиентов, выполняет фоновые операции, а контроллер может специально ограничивать rebuild, чтобы сервер не становился непригодным для работы.
Это принципиально изменило смысл старого совета «для четырех дисков достаточно RAID 5». В эпоху HDD на сотни гигабайт восстановление занимало значительно меньше времени и требовало прочитать намного меньше данных. Современный NAS с 18, 20, 24 или 30 ТБ на диск способен провести в degraded-состоянии сутки или несколько суток. Весь этот период оставшиеся накопители являются единственным источником блоков, необходимых для восстановления. Если на одном из них существует сектор, который давно не читался и теперь оказался нечитаемым, проблема проявится именно тогда, когда этот сектор внезапно потребуется rebuild.

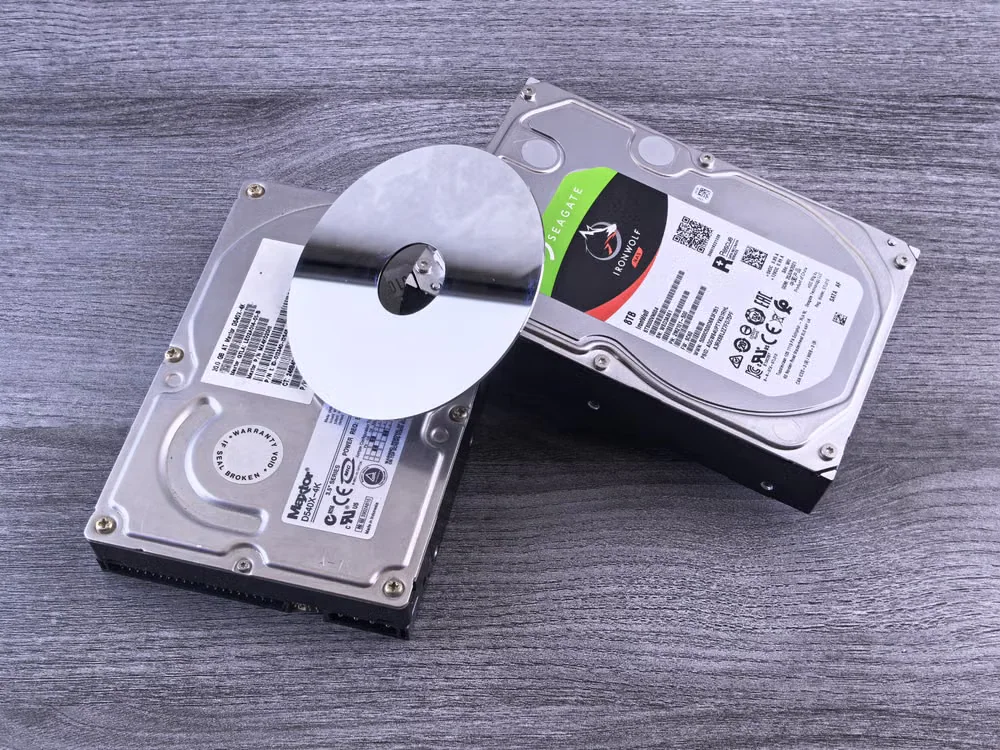
два открытых жестких диска с видимыми магнитными пластинами и головками

Фото: Andrey Matveev

Наличие большого количества HDD не означает, что каждый из них обязательно скоро сломается. Актуальная статистика Backblaze хорошо показывает реальный порядок величин на большой выборке. По итогам 2025 года компания анализировала 344 196 жестких дисков 30 моделей и получила годовой AFR 1,36%. В первом квартале 2026 года опубликованный показатель составлял 1,24%, а lifetime AFR на накопленной выборке приблизился к 1,39%. Эти цифры нельзя напрямую переносить на домашний NAS: у Backblaze другие корпуса, вибрация, температура, модели HDD, рабочие нагрузки и правила замены. Они показывают другое: отказ диска является обычным эксплуатационным событием даже в профессионально обслуживаемом парке из сотен тысяч накопителей, а не теоретической аварией, которую можно исключить покупкой NAS-серии. Backblaze публикует исходные данные и актуальную статистику по своему парку HDD.

Особенно осторожно следует относиться к популярному расчету риска rebuild через показатель Unrecoverable Read Error из спецификации HDD. Например, если производитель указывает вероятность невосстановимой ошибки чтения меньше одной на определенное число прочитанных бит, нельзя просто умножить объем массива на эту величину и объявить полученный процент вероятностью гибели RAID. Спецификационная граница не является статистическим прогнозом для конкретного диска, ошибки не обязаны распределяться так, как предполагает простая школьная формула, а контроллеры и файловые системы могут иметь собственные механизмы восстановления. Практический вывод при этом остается: чем больше данных приходится прочитать при rebuild, тем важнее заранее обнаружить проблемные области на оставшихся дисках и иметь отдельную копию данных.

Замена нескольких подозрительных накопителей требует той же осторожности. Нельзя вытащить второй диск из RAID 5 только потому, что новый для первого уже установлен в корзину. Сначала rebuild должен полностью завершиться и массив вернуться в нормальное состояние. QNAP, например, при последовательной замене нескольких дисков требует дождаться 100% восстановления после каждого накопителя и только затем переходить к следующему. Сам новый диск не восстанавливает отказоустойчивость в момент физической установки: она возвращается после записи на него всех необходимых данных.

Почему зеленый SMART не доказывает, что каждый файл читается правильно

У жесткого диска есть несколько уровней обнаружения ошибок. Сам накопитель использует собственное кодирование и коррекцию ошибок секторов. SMART сообщает накопленные показатели состояния и зарегистрированные проблемы. RAID добавляет избыточность между дисками. Файловая система может добавить еще один уровень: контрольные суммы содержимого. Эти механизмы дополняют друг друга, но один не заменяет остальные.

Представим зеркало из двух HDD. Приложение просит прочитать блок, первый диск возвращает последовательность байтов A, второй потенциально содержит последовательность B. Если один накопитель сообщает явную ошибку чтения, ситуация проста: система знает, какую копию использовать. Сложнее случай, когда оба устройства возвращают данные без аппаратной ошибки, но один блок изменился незаметно для верхнего уровня. Обычное зеркало знает, что у него есть две копии, но без независимой контрольной суммы содержимого не всегда имеет информацию, позволяющую установить, какая копия правильная.

Файловые системы с end-to-end checksums решают именно эту задачу. ReFS может хранить контрольные суммы метаданных и, при включенных integrity streams, пользовательских данных. При работе поверх зеркального или parity Storage Spaces ReFS способна обнаружить повреждение по контрольной сумме, получить корректную копию из избыточного хранилища и выполнить локальное восстановление без отключения тома. В документации Microsoft отдельно описан фоновый integrity scrubber, который проверяет данные до того, как поврежденный участок понадобится приложению. Механизм checksums, online repair и scrubber описан в документации ReFS.

открытый жесткий диск крупным планом, видны магнитная пластина, привод головок и электроника

Фото: Denny Müller

На Synology связка Btrfs и RAID показывает, почему наличие файловой системы с контрольными суммами еще не означает автоматическую защиту каждого пользовательского файла. DSM указывает, что Data Scrubbing поддерживается для Btrfs и подходящих SHR, RAID 5, RAID 6 и RAID F1, но проверка и исправление данных конкретной общей папки требует включенной опции data checksum for advanced data integrity. Если контрольных сумм нет, scrub не получает эталон, с которым можно надежно сравнить содержимое файла. Поэтому при создании NAS имеет смысл проверять не только надпись Btrfs в характеристиках, но и фактические параметры общих папок.

У RAID 5 существует еще одна отдельная проблема, связанная не со старением поверхности, а с незавершенной записью. Данные и четность одной stripe должны соответствовать друг другу. Если питание исчезло между отдельными операциями записи, часть stripe может оказаться в новом состоянии, а часть в старом. Linux kernel documentation называет этот сценарий RAID5 Write Hole и описывает Partial Parity Log как один из механизмов защиты: перед изменением stripe сохраняется информация, достаточная для восстановления согласованной четности после сбоя. У аппаратных RAID-контроллеров похожую задачу исторически решает защищенный write-back cache с батареей или энергонезависимой памятью. Поэтому ИБП для NAS полезен не потому, что жесткий диск обязательно ломается от каждого отключения электричества, а потому, что дает системе время корректно завершить записи и выключиться.

Scrub нужен до отказа диска, а не после появления первого красного индикатора

Rebuild и scrub выполняют разные операции. Rebuild восстанавливает избыточность после потери или замены накопителя. Scrub заранее проходит по существующим данным и проверяет их согласованность. В RAID 5/6 QNAP читает сектора группы и пытается исправлять обнаруженные ошибки; производитель рекомендует запускать RAID scrubbing не реже одного раза в месяц и предупреждает о снижении скорости чтения и записи во время процедуры. Synology также рекомендует периодический Data Scrubbing, а при Btrfs может совмещать проверку контрольных сумм пользовательских данных с проверкой RAID. QNAP позволяет запускать RAID Scrubbing вручную или по расписанию и рекомендует ежемесячную проверку.

Смысл профилактической проверки особенно хорошо виден на архивном NAS. Фотография 2018 года может лежать на диске восемь лет и ни разу не читаться целиком. SMART при этом способен оставаться нормальным, поскольку накопитель не обязан знать о проблеме в секторе, к которому давно не обращались. Scrub заставляет систему последовательно прочитать хранилище сейчас, пока RAID еще имеет всю избыточность. Если обнаружится читаемая с одной стороны зеркала и поврежденная с другой копия, система получает шанс исправить проблему до того, как один из дисков физически выйдет из строя.

Цена этой профилактики заметна. Проверка массива из десятков терабайт создает длительную нагрузку на HDD, занимает пропускную способность и может повышать температуру дисков. Запускать scrub каждый день на домашнем массиве обычно нет смысла. Частоту выбирают с учетом объема, нагрузки и рекомендаций конкретной NAS-платформы. Практически важнее не максимальная частота, а сам факт регулярной проверки и просмотр результата. Scrub, который месяцами завершается ошибкой или постоянно откладывается из-за выключения NAS, защиты не добавляет.

жесткий диск с открытой нижней стороной, крупным планом показана печатная плата контроллера

Фото: Bru-nO

Scrub нельзя использовать вместо резервного копирования по той же причине, по которой RAID не является backup. Он проверяет текущее состояние данных и избыточности, но не знает, что вчера файл был правильным, а сегодня приложение записало в него неправильное содержимое. Контрольная сумма нового поврежденного файла будет совершенно корректной, если файл был изменен обычной операцией записи. Для возврата к предыдущему состоянию нужна история версий: snapshot или резервная копия.

Snapshot решает часть проблемы, но его тоже опасно автоматически называть backup. Снимок позволяет быстро вернуться к предыдущему состоянию файловой системы и очень полезен против случайного удаления или массового изменения файлов. Если снимки находятся в том же storage pool, физическая гибель всего пула уничтожит и рабочие данные, и снимки. Возможность пережить отказ NAS появляется только тогда, когда существует копия на другом независимом хранилище. Для действительно важных данных это может быть второй NAS, внешний HDD, который после копирования отключается, или облачное объектное хранилище.

Как собрать домашнее хранилище, в котором отказ одного диска действительно перестает быть катастрофой

Начинать полезнее не с выбора RAID, а с классификации данных. Фильмы, дистрибутивы и другой материал, который можно снова скачать, не требуют той же схемы защиты, что семейный фотоархив, исходники видеосъемки или единственная копия рабочих документов. RAID имеет смысл для данных, которые должны оставаться доступными после отказа накопителя. Для четырехдискового NAS с большими HDD RAID 6 или аналог с двойной избыточностью уменьшает риск периода rebuild по сравнению с single parity ценой емкости одного дополнительного диска. Зеркало дает простую схему и хорошую производительность, но половина физической емкости уходит на вторую копию. Универсально лучшего уровня нет: выбор определяется ценностью доступности, количеством дисков, объемом и допустимой потерей полезного пространства.

Следующий уровень связан с целостностью. Если NAS поддерживает Btrfs, ZFS или другую систему с проверкой пользовательских данных, нужно разобраться, где именно включаются checksums и как работает scrub. Наличие слова RAID в интерфейсе этого не гарантирует. У классического RAID главная задача состоит в восстановлении блоков после отказа диска. Система с контрольными суммами добавляет возможность обнаружить содержимое, которое не совпадает с ожидаемым, и при наличии корректной избыточной копии восстановить его. Для архива, который редко читается, это одна из наиболее полезных функций NAS.

Третий уровень находится за пределами самого NAS. Рабочая копия и резервная копия не должны зависеть от одного storage pool. Для домашних данных практична схема, в которой NAS хранит основную библиотеку и snapshots, а наиболее важные каталоги дополнительно копируются на физически отдельный носитель или удаленное хранилище. Если внешний HDD постоянно подключен к NAS с правами записи, он хуже защищает от вредоносной программы или ошибки администратора, чем диск, подключаемый только на время backup. Если второй NAS стоит на той же полке и питается от того же удлинителя, он хорошо защищает от отказа массива, но хуже от кражи, пожара, затопления или серьезной электрической аварии.

Наконец, резервную копию нужно проверять восстановлением. Успешная строка Backup completed подтверждает завершение задания, но не доказывает, что нужный файл можно вернуть. Ошибочная фильтрация каталогов, потерянный пароль шифрования, поврежденный репозиторий или закончившееся место способны годами оставаться незаметными. Для важных данных полезно периодически восстанавливать несколько файлов в отдельную папку и сравнивать результат с оригиналом. После этого резервная система отвечает на практический вопрос: что именно произойдет, если рабочий NAS сегодня перестанет существовать.

В итоге надежность домашнего хранилища складывается из разных механизмов, которые часто ошибочно сводят к выбору RAID. RAID 5, RAID 6, зеркало, SHR и RAIDZ отвечают прежде всего за доступность данных при определенном числе отказавших дисков. Checksums и scrub помогают обнаруживать и исправлять повреждение уже записанных блоков. Snapshots дают историю состояний. Отдельный backup позволяет восстановиться после гибели самого массива, ошибки пользователя или другой аварии. Когда эти задачи разделены, отказ 20-терабайтного HDD становится штатной процедурой замены накопителя. Когда вся защита заканчивается зеленой надписью RAID 5 в интерфейсе NAS, первый же отказ показывает, что избыточность дисков и сохранность файлов были приняты за одно и то же.

7 показов