Перейти к содержимому
Новость

DeepSeek открыла инструменты для Huawei Ascend 950 и переносит ключевые ИИ-операции с CUDA

DeepSeek 30 сентября открыла несколько компонентов для Huawei Ascend 950: библиотеку матричных операций DeepGEMM-Ascend, коммуникационный стек DeepEP-Ascend и ядра FlashMLA. Практический смысл релиза в том, что разработчикам стало проще запускать и оптимизировать модели на Ascend без привязки всех низкоуровневых операций к CUDA.

Анатолий В.
DeepSeek открыла инструменты для Huawei Ascend 950 и переносит ключевые ИИ-операции с CUDA

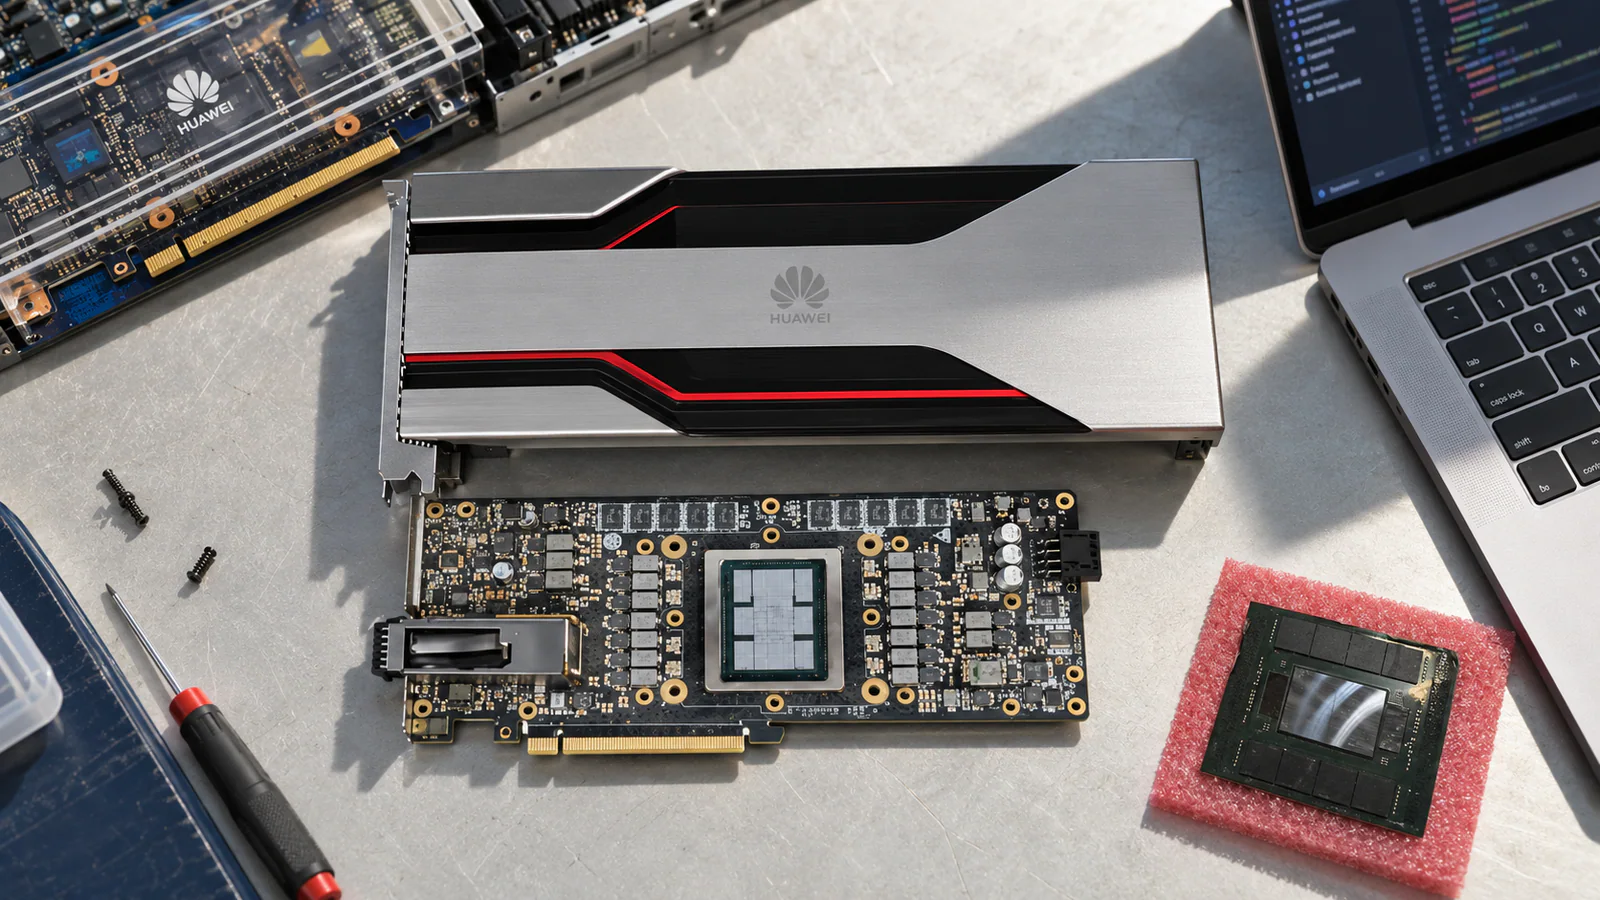
Автор: Изображение создано с помощью ChatGPT

У Nvidia сильна не одна только аппаратная часть. CUDA за годы обросла компиляторами, библиотеками и готовыми ядрами, поэтому переход на другой ускоритель часто означает переписывание и повторную оптимизацию значительной части вычислительного стека. Новые проекты DeepSeek закрывают как раз этот пробел для Huawei Ascend 950.

Один из них, официальный DeepGEMM-Ascend, содержит ядра для матричного умножения. Репозиторий опубликован 30 сентября 2026 года, разработчики указывают поддержку Ascend 950 и ориентацию на производительность, близкую к пределам оборудования. Для сборки требуется CANN 9.2, Bisheng, torch_npu и Python не ниже 3.10. Это уже не абстрактное заявление о совместимости, а конкретный программный стек, под который можно собирать вычислительные ядра.

Второй компонент, DeepEP-Ascend, занимается обменом данными между ускорителями при обучении и инференсе. В частности, библиотека реализует операции all-to-all для экспертного параллелизма в MoE-моделях. Публичный API сделан совместимым по структуре с Nvidia-версией DeepEP. В тестах DeepSeek на Ascend 950DT скорость dispatch при восьми ускорителях составляла 373-375 ГБ/с, а при 128 ускорителях - 313-320 ГБ/с. Эти результаты относятся к конкретной тестовой конфигурации DeepSeek и не являются независимыми замерами.
02_1920x1080_c7844d832412_840x473_8a38224aba

Фото: Getty Images / Kirill Kudryavtsev)

Отдельно DeepSeek добавила поддержку Ascend 950 в FlashMLA. Опубликованные ядра разреженного attention для DeepSeek V4.1 достигают заявленных 410 TFLOPS на этапе prefill и 360 TFLOPS при decoding. Разработчики оценивают это соответственно в 95% и 83% теоретического предела используемого оборудования. Здесь тоже речь идет о собственных измерениях DeepSeek, а не о независимом сравнении с ускорителями Nvidia.

Параллельно TileLang получил нативный backend для Ascend 950. Он включает генерацию кода, автоматическое планирование вычислений, синхронизацию и работу с Cube и Vector-блоками ускорителя. В результате часть низкоуровневых оптимизаций можно описывать через один язык, а не поддерживать отдельную реализацию исключительно на CUDA.

Но переносимость пока имеет четкую границу. DeepGEMM-Ascend разрабатывался и проверялся на Ascend 950, а DeepEP-Ascend тестировался на Ascend 950DT с CANN 9.2. Для прежних Ascend A2 и A3 в опубликованных данных такой же уровень совместимости не заявлен. Это значит, что новый стек пока нельзя автоматически считать универсальным решением для всей линейки Ascend.

Для России отдельного запуска этих программных компонентов не объявлялось: код опубликован в открытых репозиториях. Гораздо существеннее доступность самих Ascend 950, совместимых серверов и необходимой версии CANN. Публичных условий поставок нового оборудования в Россию в опубликованных материалах нет.

Поэтому результат релиза пока не в том, что Ascend получил полный аналог CUDA. DeepSeek открыла несколько критичных частей стека, без которых современная большая модель плохо переносится на другую архитектуру: матричные операции, обмен между ускорителями и attention-ядра. Для разработчиков, уже имеющих Ascend 950, это заметно сокращает объем работы, который раньше приходилось выполнять вокруг самого железа.

Источник: Tom's Hardware
8 показов