

Интерес Strata не столько в очередном локальном интерфейсе для нейросети, сколько в способе разложить очень большую MoE-модель по ресурсам домашнего компьютера. В репозитории Strata разработчик предлагает готовую установку для Windows и Linux: скрипт загружает движок, модель и необходимые компоненты, после чего поднимает локальный сервер с OpenAI-совместимым API и отдельным endpoint для приложений, работающих с Anthropic API.
Здесь и появляется существенная поправка к исходному анонсу. В коротком описании проекта упоминалась NVIDIA с 8 ГБ видеопамяти, но актуальный README указывает RTX 30, 40 или 50 с 12 ГБ VRAM и более. В расширенной документации 8 ГБ все еще фигурируют как работоспособный, но медленный вариант. Иными словами, считать Strata способом нормально запустить такую модель на типичной 8-гигабайтной видеокарте пока рано.
Strata запускает большую Qwen на игровом ПК, но с 8 ГБ видеопамяти есть оговорка
Strata позволяет запускать Qwen3.8-Flash-Next локально на обычном ПК, распределяя модель между видеокартой, оперативной памятью и SSD. Однако заявленные в первоначальном описании 8 ГБ VRAM сейчас выглядят скорее нижней технической границей: актуальная инструкция проекта рекомендует видеокарту NVIDIA с 12 ГБ и 64 ГБ оперативной памяти.
Автор: Niko1221
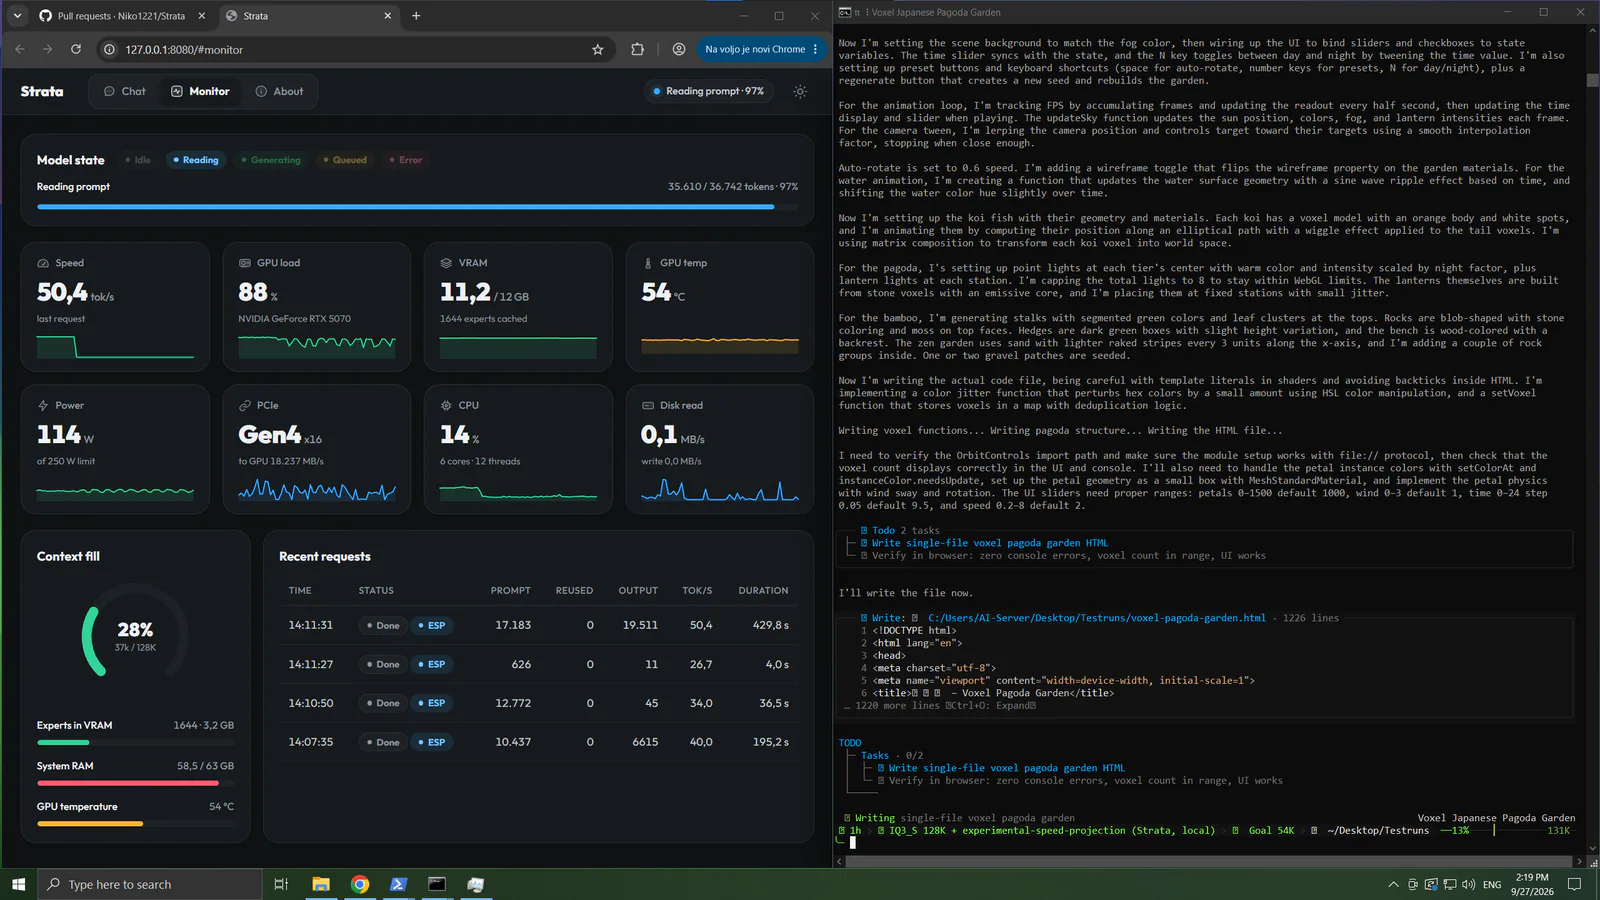
Видеопамять при этом не обязана вмещать модель целиком. Strata держит часто используемую часть вычислений на GPU, полный набор экспертов размещает в системной RAM, а крупную таблицу обращений оставляет на SSD. Для разных вариантов квантования требуется примерно от 37,6 до 54,8 ГБ суммарного пространства RAM и VRAM, причем увеличение объема видеопамяти повышает скорость, но не отменяет потребность в большом объеме оперативной памяти. Для старшей квантованной версии разработчик рекомендует уже 64 ГБ RAM.
Есть и результаты собственных измерений автора Strata. На RTX 5070 12 ГБ, Ryzen 5 7600 и 64 ГБ памяти вариант Q2_0 выдавал около 90 токенов в секунду в коротком диалоге и 67 токенов в секунду при контексте 128K. IQ3_S оказался медленнее: 52 и 41 токен в секунду соответственно. Это измерения самого разработчика проекта, независимых тестов такой конфигурации пока недостаточно, поэтому воспринимать цифры как универсальную производительность любой RTX 5070 не стоит.
У Strata есть еще одно практическое отличие от простого запуска GGUF через командную строку. После установки модель доступна через браузер, терминал и локальный API, поддерживается ввод изображений, а для нескольких совместимых NVIDIA предусмотрено распределение работы между GPU. Первый запуск тяжелый: документация предупреждает о загрузке десятков гигабайт данных в RAM и возможном заметном замедлении системы на несколько минут.
Поэтому новость интереснее первоначального обещания «125B на 8 ГБ». Strata действительно пытается сделать серверную по масштабу модель пригодной для домашнего ПК, но основным ресурсом здесь становится не одна видеокарта, а вся связка GPU, 48-64 ГБ оперативной памяти и быстрый SSD. Видеокарта с 8 ГБ может оказаться достаточной для эксперимента, но текущая конфигурация, на которую ориентируется сам проект, начинается с 12 ГБ VRAM.
Материалы по теме
- Qwen3.8-27B разогнали на одной RTX 3090, но цифра в 1000 токенов требует пояснения
- Ling-3.0-tiny запускается на Mac mini и требует меньше памяти за счет MoE
- Почему модель 70B не помещается в видеокарту на 24 ГБ: как считать память для локального ИИ
- Perplexity Portable Computer заработал на Windows RTX PC с локальным ИИ
- Edge0 держит 35B-модель в 2,9 ГБ активной памяти, выгружая экспертов на SSD