

Репозиторий NanoJev
интересен прежде всего тем, что показывает один из возможных способов построить Jev-подобную систему из доступных компонентов. В основе используется Qwen3-0.6B, к которому добавлены отдельные головы принятия решений. Вместо обычного текстового ответа модель получает состояние, вопрос и заранее заданный набор допустимых вариантов, а на выходе возвращает вероятности.
Для Choice можно передать от 2 до 255 кандидатов. Boolean рассчитан на решение с двумя исходами, а Score работает с 2–10 упорядоченными уровнями и дополнительно вычисляет ожидаемую оценку. Несколько состояний и вопросов допускается обрабатывать вместе. Авторы приводят пример, в котором 6 состояний, 18 вопросов и 44 пути кандидатов проходят через один вызов основной модели.
Это принципиально отличается от обычной схемы, когда языковая модель сначала принимает решение, а затем последовательно печатает JSON или другой структурированный ответ токен за токеном. У NanoJev итоговые вероятности считываются непосредственно с голов принятия решений, поэтому отдельного декодирования выходных токенов нет. Именно эту общую идею TypeSafe AI использует в Jev: компания описывает свою модель как систему для параллельных типизированных решений, а не для генерации текста.
NanoJev повторяет идею Jev на открытом Qwen3-0.6B, а не его архитектуру
В открытом проекте NanoJev модель Qwen3-0.6B научили выдавать решения и распределения вероятностей без последовательной генерации ответа. Это попытка воспроизвести главное свойство недавно выпущенного Jev, но не копия закрытой модели TypeSafe AI.
Автор: TianyuCodings
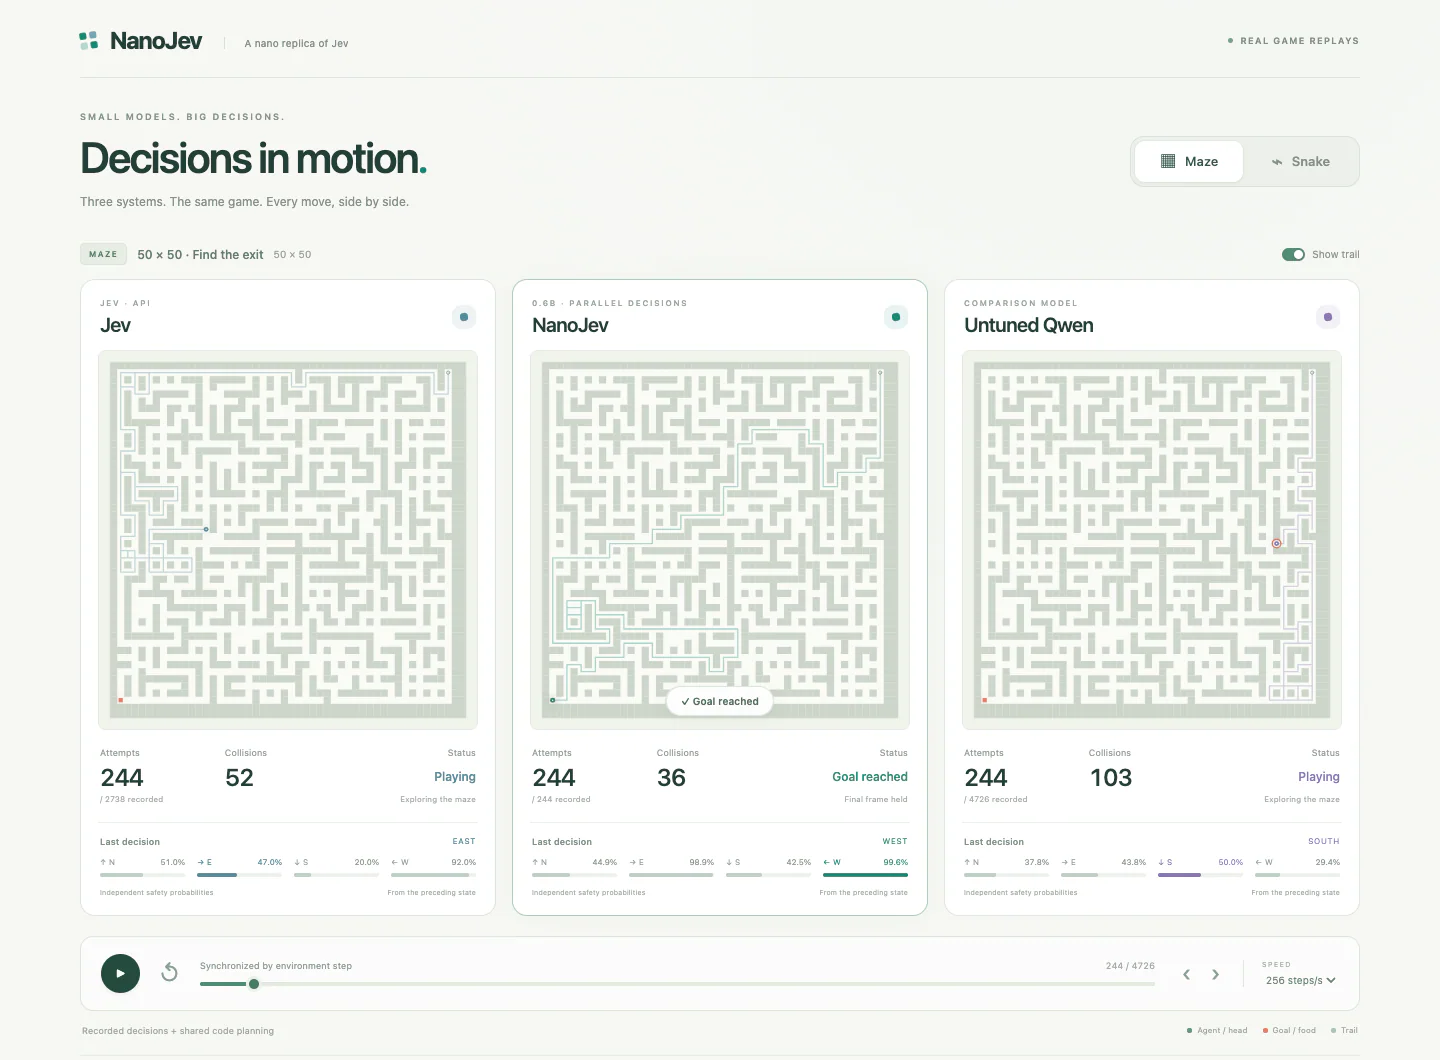
На этом сходство, которое можно подтвердить, заканчивается. TypeSafe не раскрыла достаточно деталей внутренней архитектуры Jev, чтобы утверждать, что NanoJev воспроизводит саму модель. Разработчик NanoJev использует известную основу Qwen3-0.6B и собственную реализацию голов, set attention, обучения и формирования данных. Название «nano replica» корректнее читать как функциональную реплику интерфейса и принципа работы.
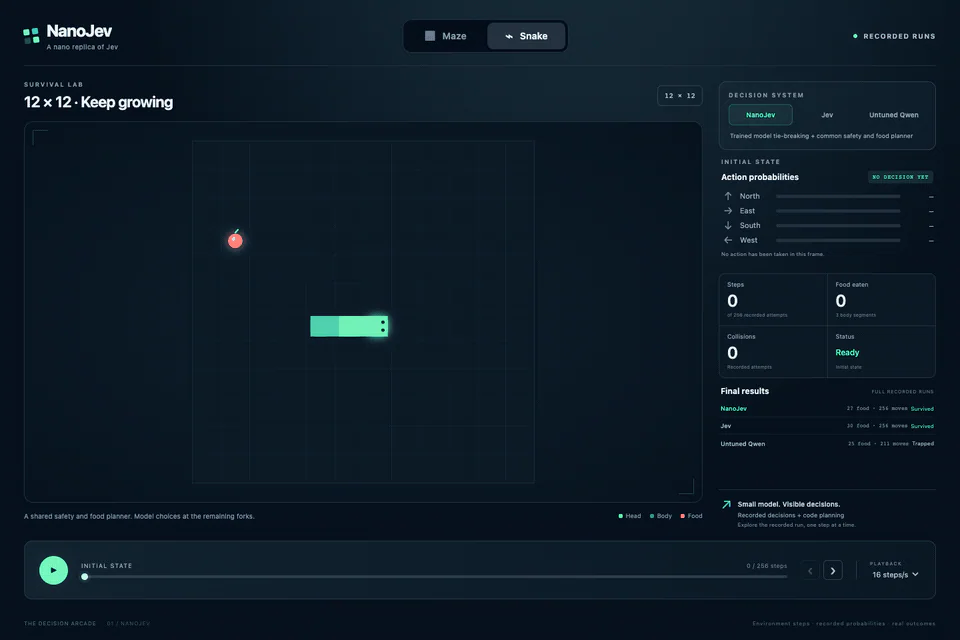
Проект при этом не ограничен демонстрационным скриптом. В репозитории опубликованы генераторы данных, обучение, оценка, локальный сервис для инференса, веса модели и набор данных. Базовый конвейер использует программно сформированные целевые распределения, а обучение оптимизирует полное распределение вероятностей для каждого вопроса. Это дает возможность воспроизвести эксперимент локально и проверить, как меняется результат после собственного дообучения.
Авторы также публикуют результаты навигационных тестов: в раннем наборе из 20 обычных и 20 OOD-карт NanoJev завершил 19 из 20 обычных и 18 из 20 усложненных испытаний. Для Jev в той же таблице указаны 20 из 20 и 19 из 20, а исходный Qwen3-0.6B без такого обучения получил 7 из 20 и 3 из 20. Это результаты самого проекта, независимого подтверждения этих измерений пока нет.
Поэтому наиболее интересная часть NanoJev находится не в попытке догнать закрытый Jev по отдельному бенчмарку. Репозиторий дает открытый и достаточно компактный пример того, как превратить небольшую языковую модель из генератора последовательности в движок ограниченных вероятностных решений. Для изучения самого Jev этого недостаточно, но для экспериментов с подобной архитектурой теперь не требуется закрытый API.
Материалы по теме
- PRINTFILM стал открытой AI-платформой для создания коротких видео и AI-сериалов
- OpenAI инвестировал в Harvey, но ее новый ИИ построен на Kimi K3
- Браузерный ИИ-агент Jev справился с Google Flights за 7 секунд
- OpenAI выложила 722 математические работы своего ИИ, но проверены еще не все
- ChatGPT Images 2.5 ускорила генерацию на 50%, а Sketch пока работает только на мобильных